人人都能整个"自己的DeepSeek Harness",那我们为啥还在给Claude Code们充会员?
"你如果不能在几个小时内重建 Cursor,下次面试会非常艰难——那不过是 300 行代码的一个 while 循环。"
Ralph Loop 创造者 Geoffrey Huntley 把软件工程师的底线划在 300 行。看似离谱,但大家发现,他可能是对的。
过去一年,Claude Code、Codex、Antigravity 等大厂产品底层路径越来越相似:Agent Loop 读写上下文、调用工具、反复执行,用测试和权限兜底。上下文、工具、Loop、记忆和多 Agent,逐渐成为一套公开的标准牌面。
大厂之外,个人 Harness 项目也在疯狂涌现。Pi 由 41 岁的奥地利软件工程师 Mario Zechner 独立开发,Aider 由约 54 岁的加拿大软件工程师 Paul Gauthier 一人发起。面向 DeepSeek 优化的 Reasonix 由游戏引擎开发者 YHH 个人发起,随后迅速发展成拥有数万 Star 的社区项目。DeepSeek 宣布招募 Harness 内测后,评论区很快变成了一场"个人 Harness 展销会"——几百个开源仓库覆盖 Coding Agent、记忆、Skills、评测和安全等方向。
世界就是这么奇妙:几个月前大家的差异还在"AI 辅助开发者生产力提升 2 倍还是 100 倍",现在的差异已经变成"能不能写一套自己的 Harness"。但当模型可以替换、Harness 可以复刻、常见组件已经趋同,连个人开发者都能拼出一套可用系统时,Coding Agent 还能靠什么打出差距?为此,InfoQ 采访了 TiDB 唐刘、腾讯研究院茹炳晟、Floatboat Harness 架构师 Remy,以及字节 Trae 天猪。
追模型不如搭 Harness?
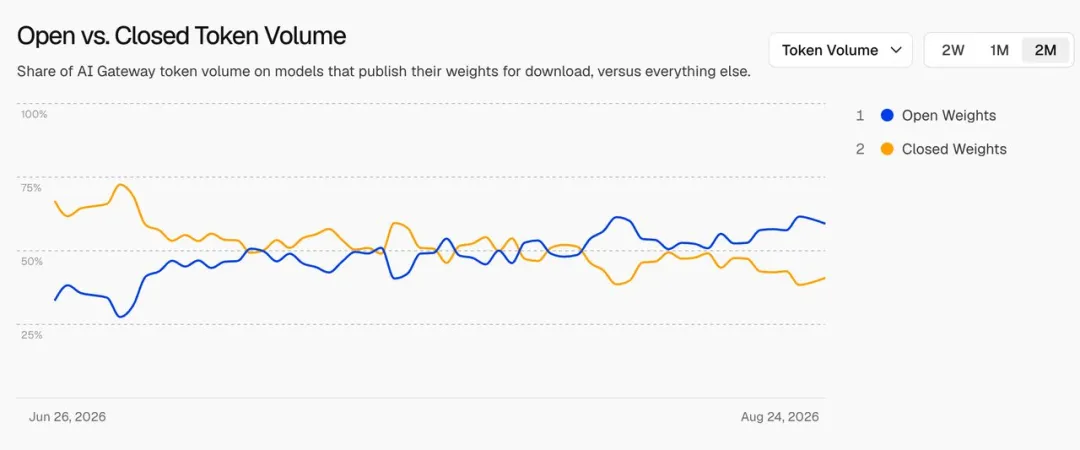
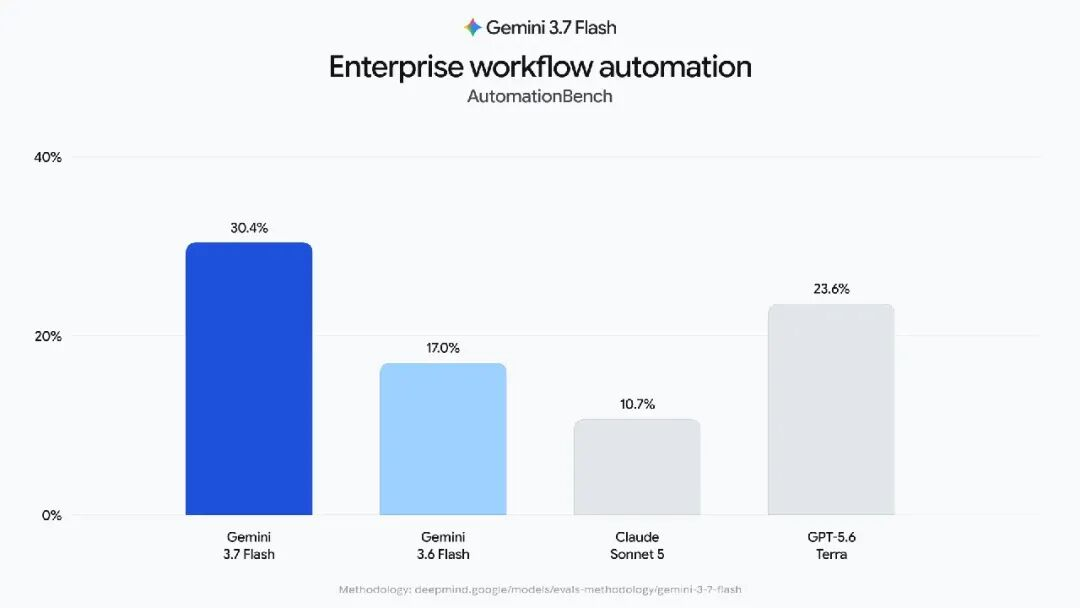
今年,多位知名 Coding 工具创始人都开始谈论一个话题:日常编程任务上,模型已经拉不开差距了。Amp 联合创始人 Thorsten Ball 直言"模型已经死了"——近距离管理单个模型的行为,回报越来越低,它们最终都会发展到"按下按钮,就能得到一个 John Carmack"的水平。OpenCode 联合创始人 Dax Raad 感受类似:模型公司在可用性方面找到了某种完美区域,"用哪个都一样"。Pi 创始人 Mario Zechner 甚至认为新版本能力还会倒退——真实世界用例太多,评测覆盖不完,所以模型厂商会选择推自家 Harness,因为那是唯一能控制的部分。
几个月前,有国内 Coding 工具专家对 InfoQ 说过:"(国产)模型不行,就只能靠工具补。模型负责决策,真正的编码、调试和重构,交给 Harness 里的工具完成。"但现在模型已经能应付大多数日常工作的复杂度,当日常任务根本触及不到模型的能力上限时,谁的上限更高就没那么重要了。既然模型拉不开差距,竞争就进入 Harness 层。
Harness 也在趋同,但趋同不是终点
Harness 不是新东西。早在 2022 年 ChatGPT 刚问世时,4000 Token 的上下文窗口逼着开发者用工具调用、MCP、RAG 来管理上下文——Cursor、Windsurf、Cline、Aider 都是那个时期的产物。后来上下文窗口大了、任务也长了,Agent 跑几个小时就开始压缩总结、遗漏关键信息。有人引入 Sub-agent,有人搞 Agent Swarm,本质上都在为底层模型搭一个更好的运行环境。"Harness"这个说法在 2026 年初广泛流行起来,但不过半年,大家的发展方向已经趋于一致。
最内层的 Agent Loop 负责模型循环、文件读写、上下文管理和安全控制,可以只有约 200 行代码。Thorsten Ball 用 315 行 Go 代码从零写出了一个能在终端读取、搜索和编辑文件的 Coding Agent。虽然核心只有几百行代码,但一套完整的 Harness 仍要向外叠加大量组件:Planner、Coder、Reviewer、Search、Edit、Shell、Sub-agent、MCP——TiDB 团队唐刘列了一串名字,然后说:"这些东西慢慢都会变成标准部件。"
他拿数据库打了个比方:MySQL、TiDB、PostgreSQL、Snowflake 都有 SQL、Optimizer、Storage Engine,但没有人会觉得它们一样。真正的差距从来不在"有没有这个组件",而在于这些组件怎么组成一个真正能解决问题的系统。
具体怎么做,TiDB 团队有自己的答案。他们的新产品 TiDB Cloud Filesystem 是一次探索——团队边推进边迭代,在与 AI 的协作过程中,同步打磨出了一套 Harness。它不是提前设计好的,而是在项目不断遇到瓶颈、定位问题、调整执行方式的过程中,被一步步"逼"出来的,成形甚至早于 Claude Code 动态 Workflow 的发布。
他们没有从零写最内层的 Agent Loop,主要基于开源项目 Pi。但任务编排、权限、持久状态、Sandbox、失败恢复,是自己动手做的。设计哲学是一句话:薄 Agent Loop,厚 Control Plane。 为什么不自己写 Loop?因为 Agent Loop 是变化最快、也最容易同质化的一层。"我们没有必要在这里内卷。站在巨人的肩膀上就可以了。"真正需要自己动手的,是数据库团队过去二十年一直在解决的问题:状态怎么持久化,权限怎么收口,副作用怎么控制,失败以后怎么恢复,一个结果到底怎么证明是真的。
这样设计的主要好处是一旦换模型、换 Agent Core 不用推倒重来。他们最开始用 OpenCode,后来换成 Pi,但不管上面的 Agent 怎么换,下面的 Sandbox、权限、状态和控制面都不需要跟着重写。这很像数据库——SQL、Optimizer 可以越来越聪明,但 Transaction、Privilege、Durability 这些边界不能因为"上层更聪明"就消失。这套 Harness 最终支撑 TiDB Cloud Filesystem 在三个月内完成开发并上线:跨 Session、Sandbox 和 Executor 的持久 Workspace,版本、分支、Checkpoint、Rollback、权限、配额与多租户隔离——全部由 Agent 完成,人类没有写一行代码,也没有审一行 PR。上线后已承载超过数百万个 Agent Workspace。
差距藏在这些看不见的地方
LangChain 联合创始人 Harrison Chase 也看到了同样的趋势,只是多了一层判断:收敛是收敛了,但它会收成一个连续的光谱。通用 Harness 已经足够胜任很多基础任务,但任务越不常规,越需要定制 Harness。促使人们走向定制端的,往往不是性能,而是可预测性和控制力——比如金融行业,客户宁愿牺牲一点智能,也要换回可控性。
具体到 Coding Agent,腾讯研究院茹炳晟认为,知识工程决定了它的能力高低。绝大多数 AI 编程工作不是从 0 到 1 开发新项目,而是在现有代码上增加功能或修复 Bug。所以 Coding Harness 的核心能力是先理解现有系统,再按照软件工程的方法判断应该在哪里做什么修改,并通过快速试错和验证形成闭环。他把一套好的 Harness 需要做到的事情拆成三层:
- 第一层:理解存量系统。 把原始需求、系统设计和代码结合起来,理解原有功能、业务逻辑及具体实现。大型项目不可能把全部代码一次性塞进上下文,怎么做顶层建模、Code Graph 机制,在需要时定位相关模块,再在模块内部通过 grep 等方式找到更细的代码片段。
- 第二层:项目约束与推理。 模型本身需要具备软件工程能力,同时必须了解具体项目和代码仓的约束。Harness 要让规则对模型可见,确保执行过程中遵守规则,并在完成后检查规则是否真正得到落实。光在 Prompt 里写"遵守规则"不够——还得有检查规则和反思机制,多轮反思的结果合并,再去做迭代。
- 第三层:确定性验证。 代码生成只是起点,Agent 说"我修好了"没有意义,你得用外部不变量证明它是正确的。Coding Harness 要与持续集成体系打通,覆盖测试生成、测试执行、结果分析和错误反馈。还需要具备单元测试环境、容器化测试环境、编译运行、结果分析和结果展示等能力。
多 Agent 编排:听着高大上,实际是"分布式内耗"
Boris Cherny 最常挂在嘴边的事,就是吹他那套多 Agent 能力——几千个 Agent 同时跑,忙的时候直接上万。Claude Code 顺势把这种玩法产品化了:Dynamic Workflows,用户给个目标,Claude 自己拆任务、调度几百个子 Agent 去搜索、编码、验证、汇总。2026 年被称为"Agent 编排之年"。
这套剧本十年前演过一次。2016 年也叫"编排之年",主角是容器。Docker 把应用标准化了,大家发现跑一个容器不难,难的是管几千个。于是 Kubernetes、Swarm、Mesos 打成一团,最后赢的是控制平面。十年后,Agent 在走同样的路。这个位置上现在已经挤满了人——大模型厂商、云厂商、企业软件巨头、开源框架、治理层平台——每家都有自己的编排方案。
其实这个判断并不新鲜。早在 2025 年,《Vibe Coding》作者、前 Google 和 Amazon 工程师 Steve Yegge 就去找过 Anthropic 的高层,告诉他们应该做一个"Agent 的 Kubernetes"——Claude Code 只是一个构件,真正的战场在上面的编排层。没人理他。于是他 8 月自己动手了,做出了 Gas Town,可以让一个人持续管理 20 到 30 个并发 Coding Agent。
但这个位置真的会像 Kubernetes 一样成为独立而统一的平台吗?TiDB 团队唐刘有一个判断,听起来像个暴论,但越琢磨越有道理:Agent 编排的未来,可能是越来越少的编排。 一两年前,让 Agent 做复杂任务得手把手教它第一步干什么、第二步干什么,写一大堆 Prompt 把协作流程塞进去。现在很多时候只需要告诉 Agent"我要这个结果",它自己就能完成大量内部规划。模型越强,一部分显式编排就一定会消失——这很像数据库的演进,早期得告诉数据库"怎么 Join、从哪张表开始",后来 Optimizer 越来越强,人只管说"我要什么"。
做分布式系统这么多年,唐刘对一件事越来越敬畏:Communication is complexity(通信即复杂度)。 十个组件频繁通信的系统,大概率难 Debug、性能也不会特别好。所以 TiDB 在多 Agent 上反而很克制,更信 Unix Philosophy:一个 Agent 做好一件事,Agent 之间靠清晰的 Input/Output 解耦,尽量减少高频聊天。"复杂性永远有成本。不要因为我们'可以'做一个复杂系统,就一定要做复杂系统。我不觉得未来一定是一百个 Agent 在 Slack 群里开会的软件公司。真正好的多 Agent 系统,反而可能看起来非常安静。"
茹炳晟对此也十分赞同——多 Agent 不是默认选项,是单 Agent 搞不定了才用的补充方案。他是 Agent Design Patterns Society(ADPS)的创始人之一,在 ADPS 的体系下,智能体设计模式被拆成两个维度:一个是认知能力(感知、记忆、推理、行动、反思、协作和治理),另一个是执行拓扑(链式、路由、并行、循环、层级和编排)。两者拼成一个二维矩阵,每个交点都可能形成一种具体的设计模式。
基础拓扑的数量确实有限,具体的设计模式却远不止十来种。更关键的是,这些模式并不天然属于多 Agent:有些必须依靠多个 Agent 协作,有些在单 Agent 内部就能完成。但无论选哪种模式,都有一个原则:只要单 Agent 能搞定,就不要引入多 Agent。因为复杂度不会消失,只会转移。 很多人觉得多 Agent 能降低系统复杂度,其实是把问题从一个地方挪到了另一个地方。
目前最明确值得付出复杂度成本的场景主要有两个:一是缓解上下文压力,单 Agent 扛全链路任务时上下文窗口很快耗尽,把子任务拆给子 Agent 是最典型也最务实的用法;二是交叉验证和发散探索,一个模型完成任务后另一个模型负责检查,两个智能体相互对话产生新的想法和碰撞。
长程是分水岭
如果通用 Coding Agent 的差距不在"多 Agent 编排",那么就需要多问一个问题:一个 Agent 连续跑 50 个小时,它还知道自己到底干过什么吗?这是通用型 Agent 框架的"终极考场"。如今,Harness 的核心模块已经高度标准化:上下文管理、任务拆解、工具调用、记忆整合——各家方案大同小异。架构趋同之后,拼的就是模块之间怎么配合。多位从业者均认为:长程稳定性,会是下一代 Agent 产品的核心分水岭。
很多 Agent 前十几步表现不错,四五十步就开始跑偏。但"长程"不只看步数——调用 50 次同一个稳定 API,未必比修改 7 个相互依赖的文件更长程。Floatboat 团队指出,真正决定难度的是依赖链深度、状态跨越的时间和工具数量、目标开放程度、操作可逆性,以及错误被发现之前需要经过多少轮反馈。
既然问题是"错误发现得太晚",解法就是让错误尽早暴露。这和分布式系统的逻辑一模一样:所有分布式系统都会失败,真正危险的不是失败本身,而是系统不断 Retry 把一个小故障放大成雪崩。唐刘越来越相信一句话:Retry is dangerous. Fail fast is underrated。 但 Fail Fast 不等于放弃任务,它只是把问题暴露时间点从"五十步之后"提前到了"十步"。真正可怕的是第十一到五十步还在错误前提上继续跑,上下文里的错误信息越攒越多,后面的 Agent 把旧错误当成事实。
唐刘的解法是从数据库研发经验中找答案:要有 Checkpoint,要有持久状态,要能换一个 Agent、换一条路径继续干。这跟数据库设计的哲学完全一致——Transaction Log、Checkpoint、Rollback、Failover。Pi 的 Harness v2 正在做的,就是把执行状态也拉入持久化范围:操作意图、执行步骤、Tool 状态、消息队列全部落盘,进程崩溃后能根据 Operation Log 判断安全恢复点。这和数据库 WAL 的思路如出一辙:状态可以丢,但日志不能丢,丢了日志就丢了真相。
再往前走一步:能恢复,能不能自改?可以,但必须是受控闭环——发现问题、生成改动、隔离评测、灰度发布、保留回滚。没有版本管理和可观测性,自进化只是在积累技术债。关键不在"能不能改自己",而在如何证明改得更好、代价可控,而且随时能退回去。Floatboat 选择全栈自研——Runtime、Agent Loop、Tools、Infra 和自进化系统 FloatSail——他们认为如果连系统内部发生了什么都不知道,长程的收敛就无从谈起。Remy 指出,模型决定"每一步判断的上限",Harness 决定"这些判断能否在长路径上积累成结果"。他们测下来,长程任务上 Harness 能多贡献 23%——模型不变,差别在模型之外的那一半系统。
编程之战结束了吗
编程只是 Harness 最早跑通的场景,但不是终点。从 2026 年初开始,国内大厂的 AI 资源就在从编程向办公场景倾斜:字节高层调整了 AI 资源分配策略,重心从消费产品转向企业服务;阿里在年初成立 ATH 事业群统一调度算力,7 月完成多条智能体产品线整合;腾讯从 3 月开始全力押注 WorkBuddy。三家大厂相继把算力、人才和预算集中到 AI 办公这条主线上。
但这场转向不是从零开始的。腾讯的路径最有代表性:CodeBuddy 和 WorkBuddy 原本就出自同一团队,Claude Cowork 发布后,四人团队只用一个周末便做出了 WorkBuddy。Trae Work 和 Trae IDE、阿里的 Qoder 和 Qoder Work 也是类似的一面两体;OpenAI 也明确表示 ChatGPT Work 与 Codex 的底层 Harness 完全共享。道理不复杂:IDE 正在经历"能力原子化",那些为人类操作设计的界面和功能正在被拆解成细粒度的 Tool 交给 Agent 按需调用。办公场景也一样——邮件、文档、日历、审批一样会被拆成 Agent 可调用的接口(飞书开源的 CLI 本质就是一套 Skill + CLI)。
这两类产品现在共享同一套 Harness 核心,区分的是调用工具:IDE 产品操作代码仓库和终端,Work 产品进入文档、网盘和邮箱。但底层逻辑一样——理解目标、选择工具、执行多步任务、维护状态、验证结果。两者的关键分界线,是交付标准能否在任务开始时被充分形式化:能写成测试的任务,核心是可靠执行;不能的,系统还要在执行中帮用户发现自己真正要什么。编程为这套 Harness 提供了最早的训练场和商业化验证,Work 则把它推向更大的市场。
工程视角小结: 这篇文章对前端/工程化读者最有价值的几点判断——(1) Agent Loop 本质是个 while 循环,200-300 行就能写出能用的 Coding Agent,真正的工程价值在 Control Plane(状态持久化、权限收口、失败恢复、Checkpoint/Rollback);(2) 多 Agent 编排常是"分布式内耗",Unix Philosophy 的清晰 I/O 解耦比花哨的编排拓扑更靠谱,复杂度不会消失只会转移;(3) 长程稳定性(而非单步能力)是下一代 Agent 的护城河,数据库 WAL/Transaction Log 的可靠性哲学直接适用;(4) Harness 正从 Coding 垂直场景泛化为通用工作基础设施,IDE 和 Work 产品共享同一套底层,差异只在调用工具集。