独家|前DeepSeek核心研究员魏浩然出任百度文心大模型多模态算法负责人
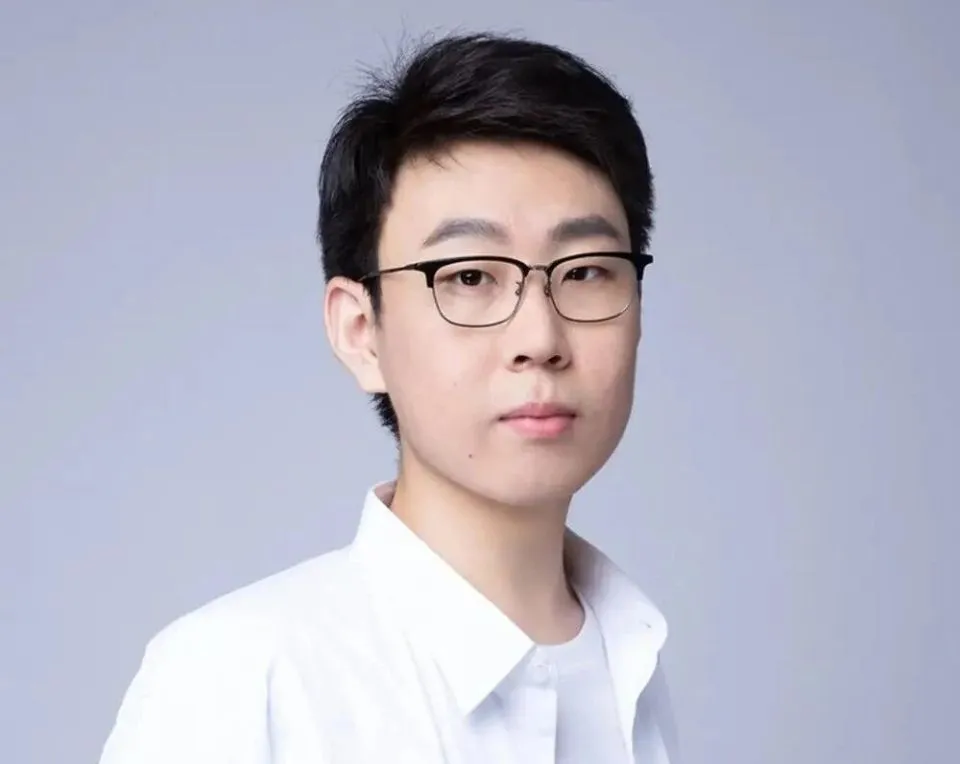
9月3日消息,据知情人士向AI前线透露,原DeepSeek核心研究员魏浩然已于近日带队转入百度基础模型研发部,出任文心大模型多模态算法负责人。
这是近期百度大力布局青年顶尖大模型研发人才的又一动作。今年7月,出生于1997年、曾主导国内首个开源对话模型复旦MOSS研发的青年学者孙天祥出任百度基础模型研发部(BMU)负责人,随后进驻百度模型委员会(BMC)与技术战略委员会(TSC)。
从孙天祥统管通用基座,到魏浩然挂帅多模态算法,可以看到,百度的模型研发中枢正加速向青年技术骨干倾斜。
多模态战绩突出
在大模型向更深层次通用智能演进的路径中,多模态能力已被公认为决定模型上限的核心支柱之一。而魏浩然身上最鲜明的技术标签,正是多模态与端到端OCR的底层重构。
据了解,魏浩然于今年上半年加入百度,此前主要负责OCR等多模态方向研发。入职后,他带领团队在端到端文档感知领域取得了重大突破,并于2026年6月22日开源了Unlimited OCR模型。该模型在业内权威的文档理解评测基准OmniDocBench测试中取得了全球第一的成绩,刷新了端到端OCR性能的SOTA纪录,登上GitHub和Hugging Face多个趋势榜单。
公开资料显示,魏浩然2023年博士毕业于中国科学院大学,此后长期专注于视觉语言模型(VLM)和文档智能研究。在加入DeepSeek之前,他曾供职阶跃星辰(StepFun)等公司,主导并参与了Vary、GOT-OCR 2.0等多项业内代表性工作。
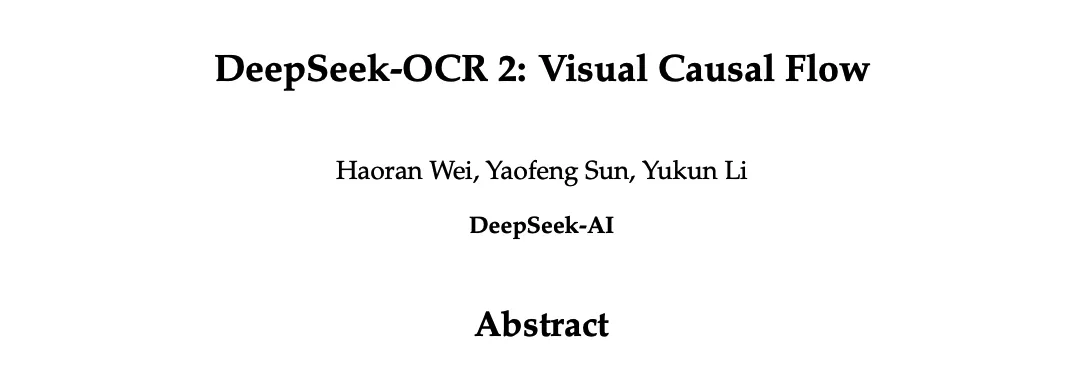
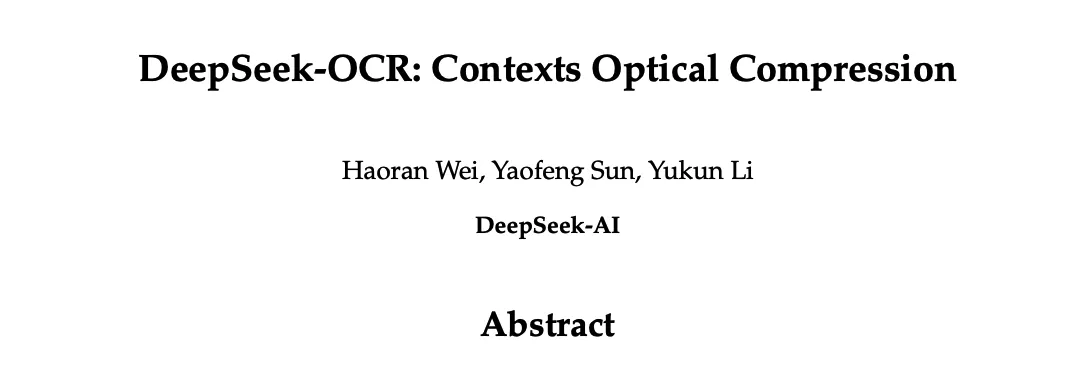
进入DeepSeek后,魏浩然进一步成为DeepSeek-OCR路线的核心研究者。在2025年10月发布的《DeepSeek-OCR: Contexts Optical Compression》、2026年1月发布的《DeepSeek-OCR 2: Visual Causal Flow》论文中,魏浩然均为第一作者。该工作在学术界和工业界引发高度关注——它没有局限于字符识别精度的提升,而是率先提出了"利用视觉表征极限压缩长文本信息"的全新技术思路。
模型通过自主研发的DeepEncoder,将传统方法中成千上万个文本Token压缩为数量大幅减少的紧凑视觉Token;在压缩率低于10倍的极端条件下,模型依然能够保持约97%的OCR解码准确率。这一探索为解决大模型长上下文输入时的显存暴涨与计算开销过大问题,开辟了一条极具想象力的高效路径。
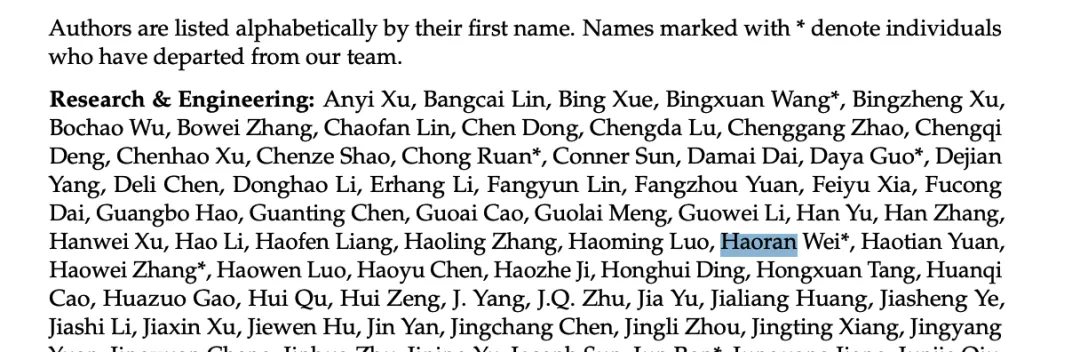
除了OCR专项模型,魏浩然也参与过DeepSeek通用基础模型研发。在DeepSeek V3.2作者名单中可以找到他的名字;今年4月发布的DeepSeek V4技术报告中,魏浩然同样位列作者,但已经被标注为离职成员。
青年骨干接管研发体系
魏浩然的调整发生在百度大模型组织持续变动的背景下。
2025年11月,百度新设基础模型研发部BMU和应用模型研发部AMU,将底座模型与应用模型研发进一步拆分。其中BMU负责高智能、可扩展的通用基础模型,AMU则更多面向具体业务和场景进行模型研发。
今年5月,百度又成立模型委员会BMC,进一步统一模型技术路线、训练和业务落地。
7月1日,复旦MOSS大模型核心第一作者、前AI4S创业公司"日行迹"创始人孙天祥正式加盟百度,执掌BMU并进入BMC;7月底百度技术战略委员会(TSC)换届,孙天祥等一线青年技术专家进一步进入TSC,标志着百度基础模型的技术决策权正式完成向新生代实战学者的交接。
在这一背景下,魏浩然此次带队进入BMU,本质上是孙天祥全面接手基础模型部门后,文心作为研发阵地重新集结的关键拼图。
另据网络流传信息,孙天祥近期还在内部宣布引入一名花名为"武钦"的研究人员,此前曾在北美某顶级前沿实验室参与数代核心大模型的研发与迭代,未来将协同团队加强文心大模型预训练能力的底层建设。
Zero 的看法
百度这波人才吸纳看似声势浩大,但值得冷静审视几个问题:
-
人才≠产出:孙天祥+魏浩然+武钦的阵容确实豪华,但大模型竞争早已过了"堆人"阶段。DeepSeek靠极简团队做出V3/V4靠的是工程纪律和文化,百度BMU能否复制这种环境存疑——大厂的组织摩擦和KPI导向往往消磨创新锐度。
-
OCR叙事的局限:魏浩然的技术标签是OCR/多模态压缩,这条路线在文档理解场景确实能打,但文心大模型的核心短板不在OCR而在推理和代码。把多模态负责人放进BMU,是补强还是错位配置?如果只是"有名头的人来撑场面",实际价值存疑。
-
离职标注的信号:V4报告里魏浩然已被标为离职——这说明他在DeepSeek V4周期后期就已经离开。从DeepSeek跳到百度,是从"技术理想主义"环境到"业务驱动"环境的切换,水土不服的概率不低。
-
真正的看点:不是谁来了,而是来了之后能不能拿到算力和数据权限。百度如果真想追赶,需要的不是更多Paper一作,而是敢赌预训练Scale的决策魄力和长期投入承诺。目前看,这些信息文章里一个字都没提。