刚刚,Gemini 4 Argon 发布:多项基测碾压 GPT-6 Astra,已参与谷歌 80 万行内核代码迁移
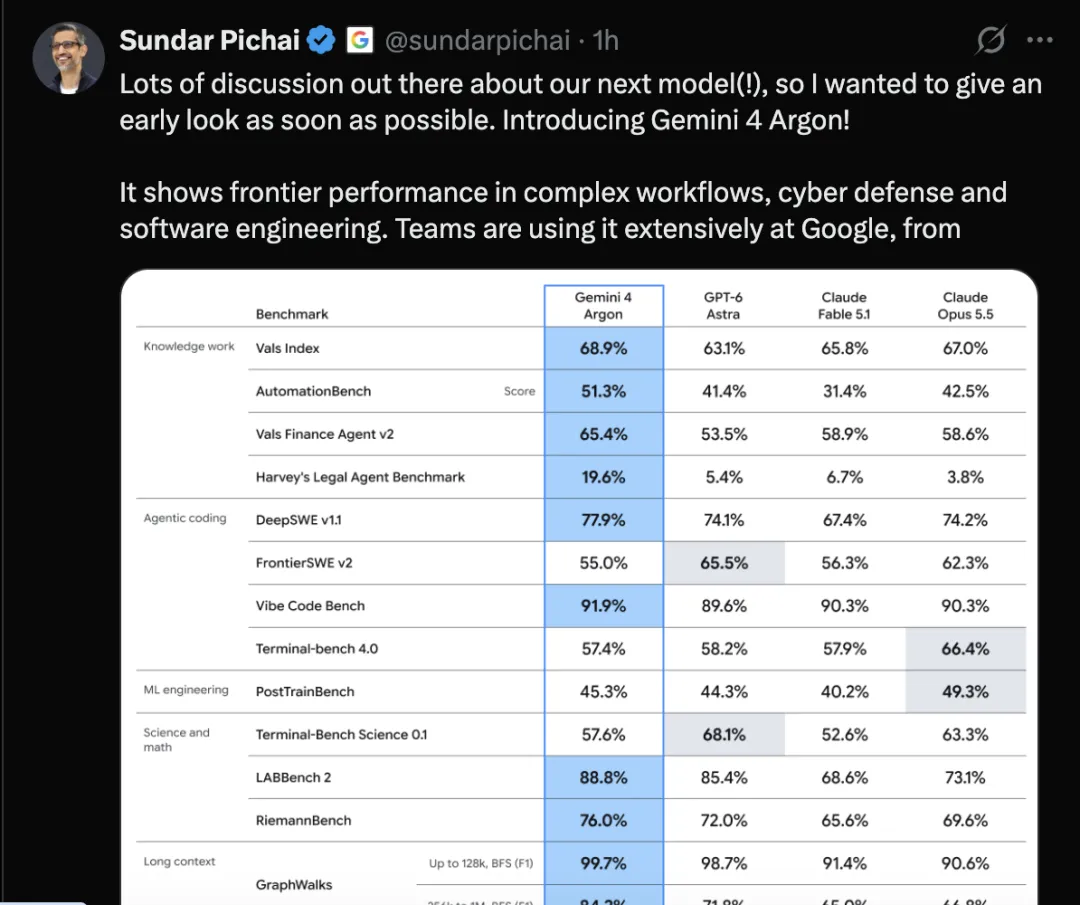
2026 年 9 月 30 日,谷歌 CEO Sundar Pichai 在 X 上宣布新一代模型 Gemini 4 Argon 正式发布。与此前主打通用对话和消费级应用的 Gemini 版本不同,Argon 的定位明确收窄为三个方向:长流程软件工程、法律与金融等企业知识工作、网络安全防御。
分阶段开放:先给安全团队,不向所有开发者开放
Argon 目前通过 Fairwind 计划向一批受信任的网络安全防御团队开放,尚未面向所有开发者和消费者上线。谷歌表示后续开放将从付费 API 客户和 Google AI Ultra 订阅用户开始,但未公布具体时间表。这一策略引发了社区关于"跑分领先但普通开发者用不了"的讨论(详见下文)。
定价
| 项目 | 价格 |
|---|---|
| 输入 Token | $2 / 百万 |
| 输出 Token | $10 / 百万 |
| 缓存输入 Token | 较普通输入低 95% |
1 输出上限从 64K 提高至百万 Token
Argon 的一项核心变化是输出 Token 上限从此前的 64K 提升至 100 万。注意这里的百万指的是输出上限,而非输入上下文窗口。
谷歌的逻辑是:更大的输出空间让模型在单条执行轨迹中进行更深层推理、生成数十万 Token,从而支撑更长、更复杂的多步骤任务。对于软件迁移、金融研究和企业流程执行,这试图解决的是任务持续性问题——模型需要在多轮分析、验证与修改中持续推进工作,而非仅生成一次性回答。
工程视角:输出上限 ≠ 任务完成能力。实际效果仍取决于模型能否保持目标一致、正确调用工具、并自主发现和纠正执行中的错误。百万 Token 输出是必要条件,远非充分条件。
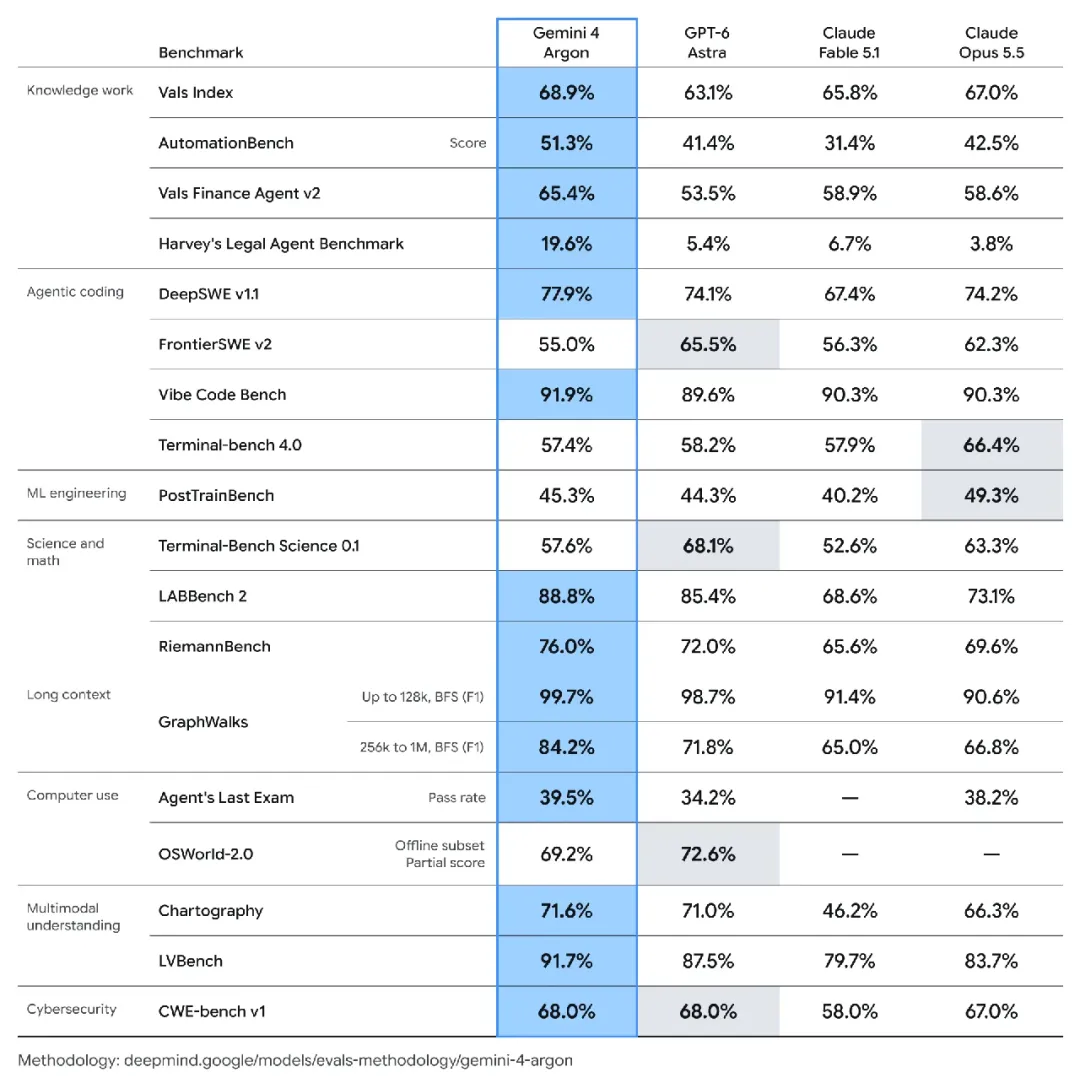
基准测试表现
| 评测 | 得分 | 说明 |
|---|---|---|
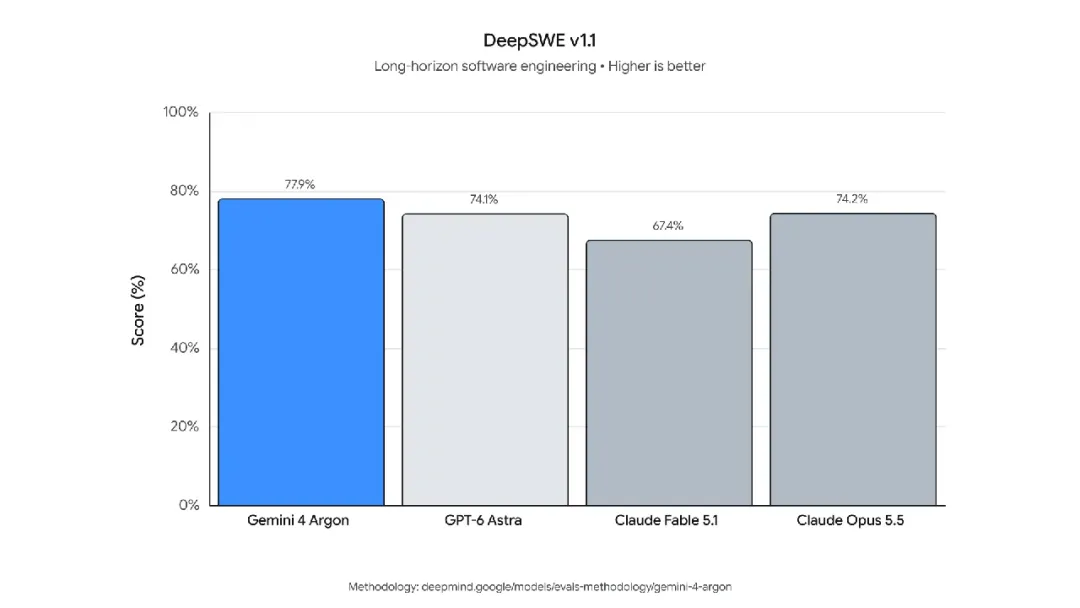
| DeepSWE v1.1 | 77.9% | 真实长流程软件工程能力,创该评测新纪录 |
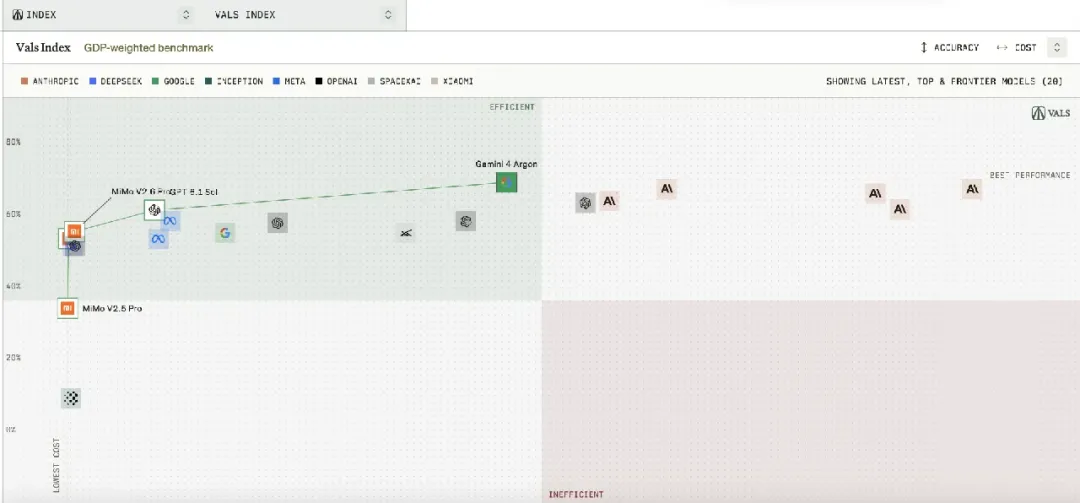
| Vals Index | 领先 | 覆盖金融、编码、法律、税务(按美国 GDP 贡献加权) |
| Vals Finance Agent v2 | 领先 | 多步骤金融研究 |
| Harvey 法律智能体评测 | 领先 | 法律领域 |
| AutomationBench (Zapier) | 51.3% 排名第一 | 端到端业务执行力 |
| LVBench | 91.7% | 长视频理解,行业领先 |
| CWE-bench v1 | 68% 并列第一 | 安全漏洞修复能力 |
2 从生成代码到代码库迁移与性能优化
与评测分数相比,谷歌披露的内部工程案例更值得关注——它们指向了 Argon 的实际使用范式:让模型进入分析→修改→测试→优化的连续工程闭环。
C/C++ → Rust 迁移
Argon 智能体正在参与谷歌内部 C/C++ 代码库向 Rust 的迁移,规模从 re2、libgav1 等核心库的数万行,扩展至 Fuchsia 操作系统 Zircon 内核的 80 多万行。谷歌明确表示大规模重写仍需经过严格的自动化和人工审计、仿真测试与评审,并未全部完成或投入生产。
libgav1 视频解码器优化案例
- 基于已有 Rust 移植版本,替换约 3.2 万行 SIMD 代码
- 工作流程:多轮性能剖析指导实验 → 研究编译器输出 → 生成可由编译器自动向量化的安全 Rust 代码
- 结果:运行速度达原 Rust 移植版本的 2.7 倍,进一步接近优化的 C++ 实现
- 比较对象为此前的 Rust 移植版本,不等于 C++ 版本的 2.7 倍
数据中心内存优化
一组 Argon 智能体通过分析服务器集群性能遥测数据,自主识别并实施数据中心内存优化,已释放超 300 TiB 内存,预计总节省量可达 500 TiB 至 1 PiB。
量子算法研究
Argon 被用于优化关键子程序的时空资源开销。一个案例中模型仅用几分钟便取得比已发表基准方案好 40% 的结果,但博客未披露具体任务与完整实验条件。
工程视角:这些案例的共同模式是"模型进入连续工程流程,以程序性能/资源消耗/功能一致性作为检验结果"。对前端工程师而言,值得关注的是这套"分析→修改→测试→验证"闭环是否能复用到前端构建链路(如 bundle 体积优化、渲染性能调优)。
3 网络安全能力先向受信任团队开放
网络安全防御是 Argon 此次优先开放的的核心领域。谷歌对 Argon 进行了专门训练,使其具备自主发现、验证并修复关键软件漏洞的能力。
关键安全能力提升(相比 3.8 Flash Cyber):
- 谷歌内部综合漏洞基准:发现涵盖 20 种编程语言的复杂代码库中的各种漏洞
- Wiz 黑盒渗透测试基准:在无源代码情况下分析实时 Web 系统,在发现攻击面、识别漏洞、生成概念验证证据方面优于 3.8 Flash Cyber
- 早期演示中发现了一个泄露全球医院医疗保健软件敏感个人信息的关键漏洞,此前前沿模型未能发现
安全防护措施:
谷歌在扩大开放前计划加强四方面:防滥用、提示注入防御、对齐偏差监测(alignment monitoring)、运行环境加固。对齐偏差监测直接针对模型执行任务时的越界行为——监测 Argon 的思维链和行动,在超出用户意图推进任务时必要时停止执行。类似系统已用于训练过程监测,但谷歌强调需谨慎处理,避免将监测发现反馈到训练中导致模型学会规避监测。
4 "跑分领先,但普通开发者还用不了"
发布策略引发了社区讨论。X 用户 Komal 指出 Argon 目标领域包括编码、企业知识工作和安全防御,但谷歌选择先向"受信任测试者"开放,"最后这一点可能才是最值得关注的"——关注的不是跑分,而是高能力模型开放节奏的控制方式。
用户 Eddie Codes 的质疑更直接代表开发者群体:
"所以它在基准测试中领先,但普通开发者还无法使用 API。先向受信任合作伙伴开放,意味着又要经历一次等待名单。"
这反映出一个结构性矛盾:公开评测成绩与实际可用性之间出现距离。对开发者而言,模型是否能直接调用、是否有稳定 API、何时开放访问,往往与性能指标同样重要。模型能力提升之外,降低实际使用门槛同样关键。