On JavaScript's Weirdness
引言部分作者就划清了边界:他要讨论的不是 '0' == 0 这种 linter 早就兜底的表层问题,而是那些藏在规范里、linter 抓不到、教程不提的隐性陷阱,且全部可在任意 ECMAScript 环境(浏览器 / Node.js,开不开 use strict 都行)复现。
#1. eval 比你想的更糟
这一节揭示的核心是:ECMAScript 的函数调用算法对 eval 这个名字做了硬编码特判。直接调用 eval("console.log(s)") 能访问外层作用域变量,但只要把 eval 重命名后再调用,就只剩全局作用域可用。
function a(s) { eval("console.log(s)"); }
a("hello"); // prints "hello"

function b(s) { const evalButRenamed = eval; evalButRenamed("console.log(s)"); }
b("hello"); // ReferenceError: s is not defined
规范中对每次函数调用都走一段"判断被调用者是不是 eval"的算法分支:
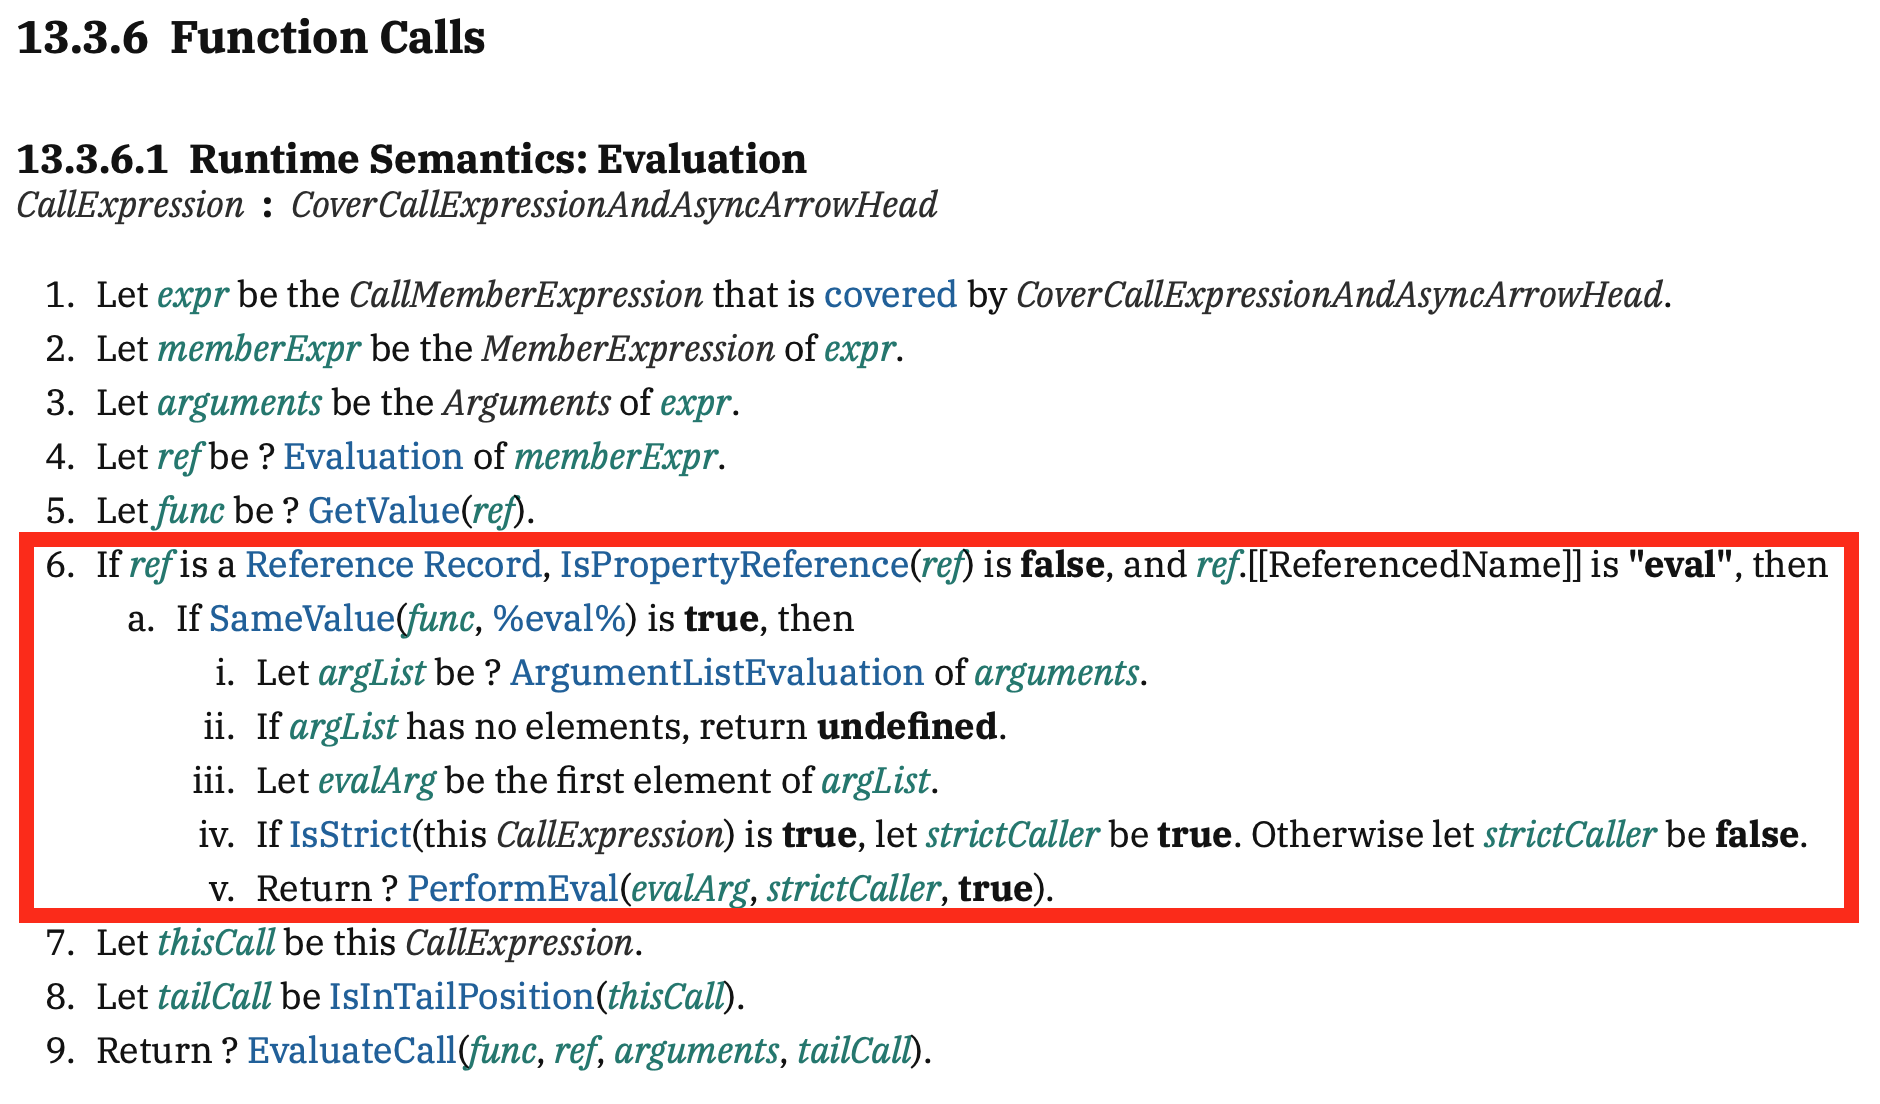
作者的工程视角点评很到位:引擎会优化掉热路径,所以没有直接性能损失,但它让构建工具与引擎实现复杂化——典型后果是 (0, eval)(...) 与 eval(...) 语义不同,minifier 在做死代码消除时必须把这层语义考虑进去。对做打包器/编译器的人来说,这是个不可忽视的 corner case。
#2. for 循环假装变量按值捕获
这段是全文最反直觉的一点。看两段对比:
for (let i = 0; i < 3; i++) { setTimeout(() => console.log(i)); }
// 0 1 2

let i = 0;
for (i = 0; i < 3; i++) { setTimeout(() => console.log(i)); }
// 3 3 3
仅仅是把 let i 从循环头提到外面,闭包行为就变了。作者用 C++ [byValue] vs [&byReference] 对比解释了"按值/按引用捕获"的语言学概念,并指出 JS(与 Java/C#)默认按引用捕获。ECMAScript 专门为"在循环头用 let 声明的变量"做了特殊处理:每次迭代创建一个新绑定。
更精彩的是作者给出 spec-compliant 的 for 循环展开形式:
let _iteratorVariable = 0;
while (_iteratorVariable < 3) {
  let i = _iteratorVariable;   // 每轮重新绑定 i
  // ... body ...
  i++;
  _iteratorVariable = i;
}
这个例子能帮助做静态分析/Symbolic Execution 的工程师理解为什么简单的"循环展开"重写会改变语义——对写 babel 插件、做代码等价变换的人有直接参考价值。
#3. 那个 falsy 对象
JS 的 8 个 falsy 值是常识,但规范里其实藏着第 9 个:document.all 是个对象却 falsy。
console.log(Boolean(document.all)); // false
这并非 DOM 标准里的怪胎,而是写进了 ECMAScript 规范。原因是为兼容 IE 时代的 if (document.all) { IE 分支 } else { 其它浏览器 } 写法——其它浏览器为了既能通过嗅探、又能让代码走 getElementById 快路径,索性让 document.all falsy。
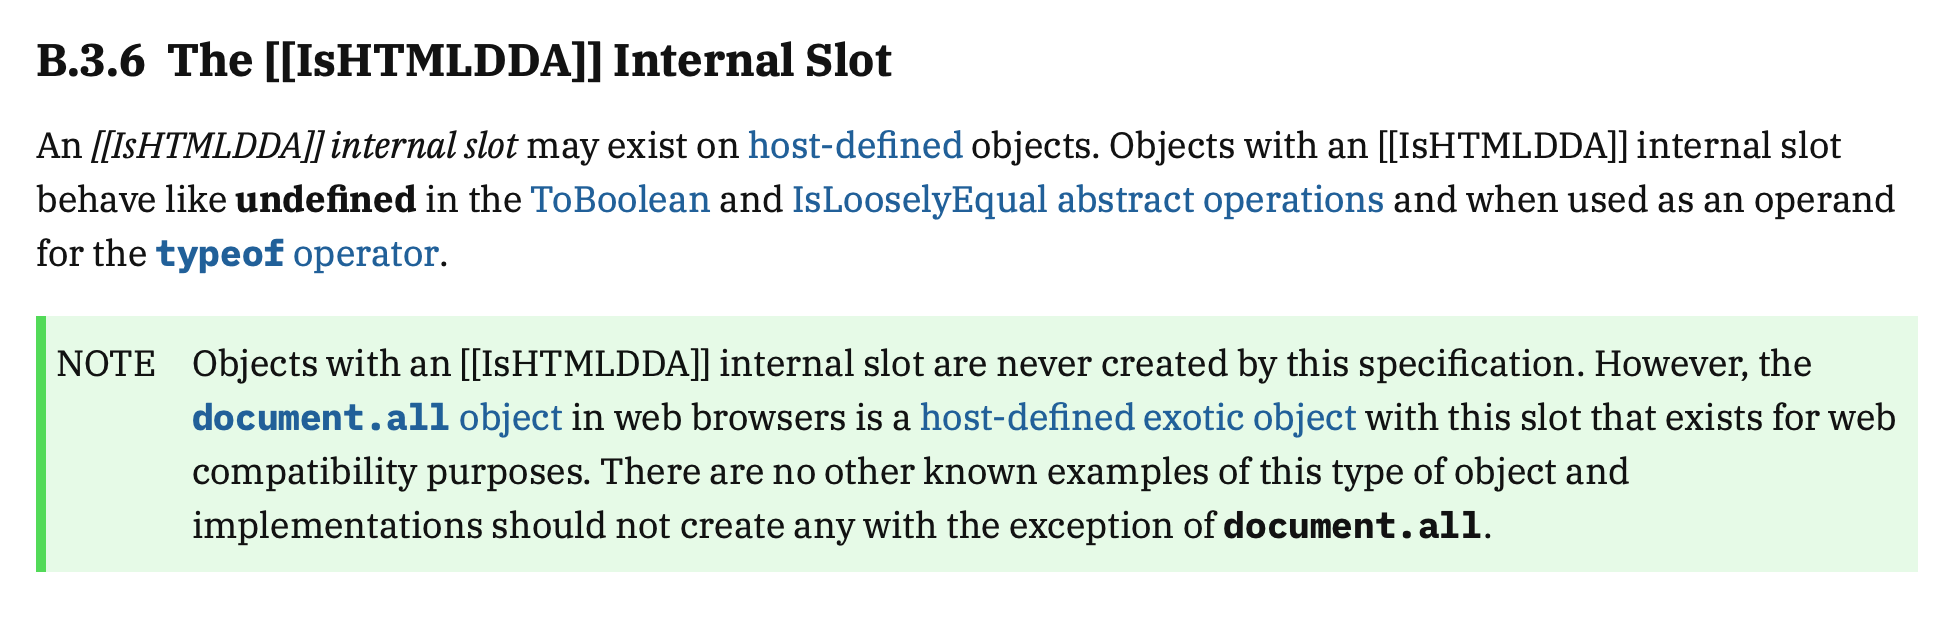
这是"历史包袱反向渗透到语言核心规范"的典型样本——做兼容性策略和 feature detection 的人值得记住:你今天写的 UA 嗅探,可能十年后变成语言规范里的硬编码特例。
#4. Grapheme 与字符串迭代
UTF-16 surrogate pair 是老生常谈,但作者把问题引到了更深的层次。一个 family emoji 👨👩👧👦 用 ZWJ 串联四个 codepoint,复制两次后:
family.length→ 23(UTF-16 code unit 数)for...of迭代 → 15(Unicode codepoint 数)new Intl.Segmenter().segment(family)→ 1(extended grapheme cluster)
JS 同时混用了四种"字符串长度"定义:UTF-16 单元数、codepoint 数、显示字符数、扩展字素簇数,几乎每个 string API 都在不同口径间横跳。作者还附了一张把同一字符串按四层拆解的对照图(UTF-16 / Unicode / Display / Intl),是做 i18n 处理时最值得收藏的直觉材料。
对做文本编辑器、输入法、IME、富文本 diff 的前端工程师,这块直接关系到光标移动、selection range、char count 显示等真实 bug。作者推荐了 Henri Sivonen 关于其它语言处理方案的对比文章,并承认 i18n 本质是个难题——没有银弹。
#5. 稀疏数组
const sparse = [1, , , 4];
sparse.forEach(e => console.log(e)); // 1 4 —— 跳过空槽,不打印 undefined
稀疏数组的"空槽"和显式 undefined 元素是两个东西。Object.entries([1,,,4]) 只返回 [['0',1],['3',4]],说明这些位置根本没有属性。后果是 map / forEach / filter 等内置方法会静默跳过空槽,导致行为与直觉不符。
更隐蔽的是 new Array(n) 默认就生成稀疏数组:
new Array(4).map(x => 123);           // [empty × 4],map 不触发
new Array(4).fill(undefined).map(x => 123);  // [123,123,123,123]
Array.from({ length: 4 }, () => 123); // [123,123,123,123]
作者提醒:稀疏数组性能极差(V8 等引擎无法走 packed 元素快路径),原则上应彻底避免。对写底层库、做性能优化的工程师,这是一个容易漏掉的低级性能杀手。
#6. ASI 的诡异之处
function f1(a, b, c, d) {
  [a, b] = [b, a]
  [c, d] = [d, c]
  console.log(a, b, c, d)
}
f1(1, 2, 3, 4)   // 输出 4 3 3 4,而不是 2 1 4 3
问题出在 ASI 没在两行解构之间插分号,于是被解释成:
[a, b] = [b, a][c, d] = [d, c]
//         ^^^^^^^^ 数组成员访问
//                  ^ 逗号运算符
作者解释了 ASI 的本质:只有当"不插分号就产生语法错误"时才插分号,否则不插。这对规范委员会是沉重的负担——加新语法可能让旧的语法错误消失,从而破坏 ASI 既有行为,所以规范里又引入了 restricted productions(如 return、++ 等)作为补丁。
对做代码格式化、prettier-like 工具、lint 规则开发、或写 babel transform 的人来说,这个例子直接揭示了"无分号风格"在解构场景下的脆弱性。
Et cetera
作者列了一串"没空间展开"的坑清单:== / !=、类型强制转换、this 绑定、NaN !== NaN、+0 vs -0、IEEE 754 浮点精度、typeof null === "object"、非严格模式 / var、构造函数返回原始值、原型链污染、Array.sort 默认按字符串排序……这清单本身就是一份 JS 面试 / 培训的复习提纲。
Zero 的看法
这篇文章最大的优点是不满足于"JS 真奇葩"的表层吐槽,而是把每个怪象都钉到 ECMAScript 规范的具体条款上,给出 spec-compliant 的等价展开形式或对照图——这种"从现象到规范"的还原路径,对做编译器、静态分析、打包器、以及写 lint 规则的工程师才是真正有价值的视角。
几点批判性思考:
-
eval特判那段略有夸大"insane"。在语言演化史里,对eval做 direct vs indirect 区分其实是为了让引擎能安全优化 indirect eval(可视为纯函数不污染调用者作用域),这是有意的设计权衡,而非单纯 hack。作者也承认了引擎优化兜底,但叙事上偏"吓人"。 -
for-loop
let那段,把"每次迭代新建绑定"说成"hack"略显不公。这其实是 ES6let块级作用域语义的自然结果,Perl/Ruby 也有类似 closure-over-iterator 的 per-iteration 绑定设计。真正"反直觉"的是var那套旧的函数级提升,而不是let。作者把新旧语义混在一篇里讲,容易让新手误以为let本身有缺陷。 -
稀疏数组与 ASI 那两节是最实用的,应该被收录进任何严肃的 JS code style guide。前者关系 V8 元素种类(packed / holey / dictionary)的性能分叉,后者关系无分号流派的边界 case——
[a, b] = [b, a]这种解构换行就是 prettier 默认要加;的核心原因之一。 -
缺一个收尾的"应对策略"小节。文章停在"列坑"层面,但对工程师来说,更有用的是落地建议:用 ESLint 的
no-eval/no-array-constructor规则、强制Array.from替代new Array(n).map、在团队风格里要求解构赋值显式分号、用Intl.Segmenter处理用户输入长度。这些是从"知道了"到"工程上不再踩"的最后一公里。
总体而言,这是一篇密度高、引用规范到位的好文,适合作为团队内部 JS 进阶分享的素材,尤其推荐给写工具链和做 i18n 的同事。