StartLux推出开源决策模型StartLux-Decision,38项基准中31项高于Jev
StartLux(原点星辉)将团队自建的 Auto Research 研发管线用于决策模型,3 天完成 StartLux-Decision 的研发与验证,一次性推出 0.8B、2B、4B、9B、27B 五档版本。这是 StartLux 推进 RSI(递归式自我改进)的核心路径之一——让 AI 深度参与数据构造、训练、评测与失败分析,加快模型迭代。
核心评测数据
| 指标 | StartLux-Decision-27B | Jev 1.13 | 差值 |
|---|---|---|---|
| Decision Index 0.2.1 综合得分 | 63.88 | 57.91 | +5.97 |
| 38 项基准中领先项数 | 31 | — | — |
| 七套测试平均准确率 | 91.82% | 88.74% | +3.08pp |
| 公开 JevBench 答对题数 | 208/231 | 199/231 | +9 |
| JevBench-Hard 错题数 | 23/111 | 31/111 | -8 |
同快照中 Rune 26B-A4B(57.44)、Decider chat 31B(57.33)、AutoJev-27B(56.40)均低于 StartLux-Decision。9B 版本以 58.63 分同样超过 Jev 1.13。
编辑判断:以上为团队自测,非官方上榜结果。Decision Index 是经随机基线校正、加权汇总的指数,不是直接准确率。训练数据使用了 38 项基准中 14 项的公开训练集(对应测试题已过滤)。这一点需要在引用数据时保持审慎。
技术亮点:跳过文本生成的决策范式
StartLux-Decision 最值得关注的工程思路是:模型直接输出选择项及概率,不必生成回答文本。这与传统 LLM 生成式回答有本质区别:
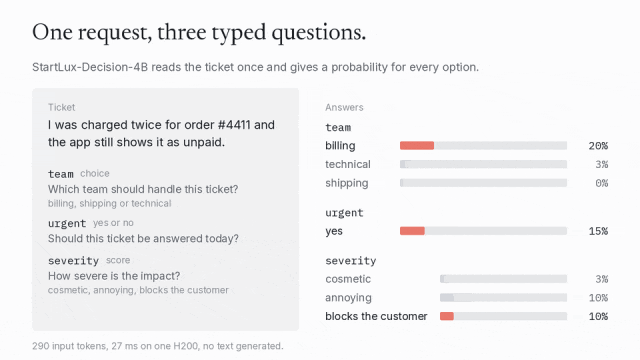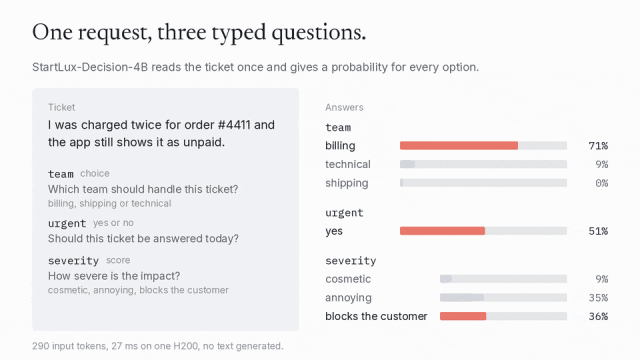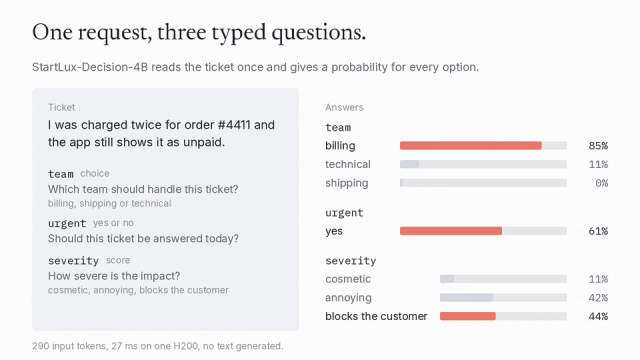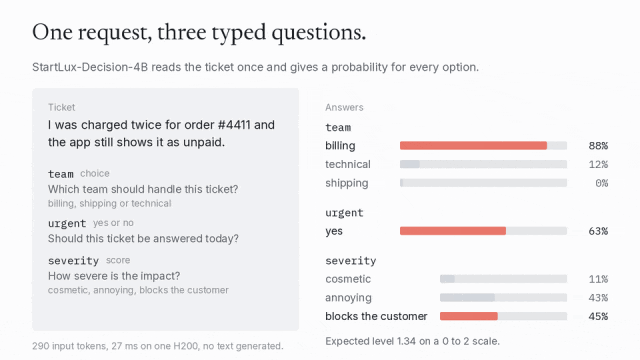
- 一次请求完成多判断:支持选择题、是非题和等级评分混合。以客服工单为例,"订单被重复扣费但仍显示未支付"可同时对应三个判断——交给哪个团队、今天是否处理、影响严重程度——在一次前向计算中完成。
- 连续网页操作:每步回答两个问题——下一步操作哪个控件,任务是否已完成。执行系统按模型选择操作页面,再将更新后的状态交给模型进入下一轮判断。购物演示中,模型同时考虑型号、包装数量、价格和配送条件,而非简单选最便宜的商品。
- 概率输出作为分流接口:候选项概率为模型协作提供明确路由。常规场景直接执行决策;候选项难以区分、状态不充分或风险高时,补充观察、交给大模型分析或请求人工确认。需注意概率输出不等于真实成功率,分流阈值需结合业务数据校准。
推理时延与工程优化
单卡 H200、BF16、本地 HTTP 短请求测试:
| 模型 | 三问题请求时延 | 单是非题时延 |
|---|---|---|
| 0.8B | 12.2 ms | — |
| 2B | 15.5 ms | — |
| 4B | 26.0 ms | 14.7 ms |
| 9B | 35.7 ms | — |
| 27B | 102.3 ms | — |
对照参考:Jev 1.13 同类三问题请求服务端耗时 64.0 ms(API 网关报告,硬件和服务栈不同,不构成严格同硬件倍速比较);Intern-Decision 在 RTX 4090 上 0.8B/2B/4B 分别约 34.0/33.3/44.2 ms。
关键工程收益:StartLux-Decision-4B 未启用 CUDA Graph 时为 90.3 ms,启用后降至 26.0 ms(3.5x 加速)。项目同时使用快速线性注意力算子,并将多个问题合并到一次前向计算,减少重复计算与调用开销。超过 26 个候选项时,服务会分组筛选并做后续决选。
量化与本地部署
五档版本均提供原始权重及三种 GGUF 格式(BF16、Q8_0、Q4_K_M),共 15 个 GGUF 条目,面向 llama.cpp 部署。以 4B 为例:
| 格式 | 文件大小 | JevBench 决策一致率 | 答对题数 |
|---|---|---|---|
| 原始权重 | — | 100% | 204/231 |
| Q8_0 | 4.48 GB | 100% | 204/231 |
| Q4_K_M | 2.71 GB | 98.3% | 201/231 |
接口采用 TypeSafe 的 /v1/systemone,兼容原有 Jev 客户端数据结构。GGUF 部署由 llama.cpp 承载模型,配套决策服务负责组织问题并读出选项结果。代码许可 Apache-2.0,模型权重 CC BY-NC 4.0(商业使用需另行授权)。
分领域能力:领先与短板并存
Decision Index 分领域得分(旗舰 27B vs Jev 1.13):
- 语言理解:74.5 vs 62.0(+12.5)
- 检索与分类:66.8 vs 55.4(+11.4)
- 工具与自动化:82.2 vs 75.1(+7.1)
- 艺术与人类偏好:领先
- 知识与推理:44.3 vs 51.4(-7.1,Jev 领先)
- API-Bank:未领先
这组数据有工程参考价值:综合得分领先不等于全域能力更强。选择模型应回到实际任务中最常遇到的判断类型,而非只看总分。StartLux-Decision 在"理解条件→候选区分→选择操作"这条链路上优势明显,但知识与推理和 API 调用场景仍需补充。
游戏环境测试:决策节奏与接口边界
Mario、DOOM、StarCraft II、JevBall 四款游戏提供了状态持续变化、动作执行后快速反馈的测试环境。但需注意这些演示并非统一的"直接读屏"测试:
- Mario 先在模拟器试运行 11 种候选动作,结果写成文字供模型选择
- StarCraft II 的采集、建造与单位控制由脚本执行
- DOOM 状态来自游戏引擎,瞄准、寻路、脱困由代码处理
- 模型只负责各自接口定义的决策,不包办全部感知与执行
不同游戏对应不同决策节奏:StarCraft II 每 12 秒提交一组三个问题;DOOM 同步判断目标、开火、移动;JevBall 持续运行,一次请求为多名球员选择动作,迟到回答由游戏策略兜底。
Auto Research 与 RSI 路线
StartLux-Decision 背后是 CTO 郭权玮带领建设的 Auto Research 管线:AI 不只执行预设实验,还根据上一轮结果分析失败、提出新假设,参与决定下一步研究什么;研究目标、评价标准和关键规则仍由人把关。这次将该方法落地到专用决策模型迭代,围绕"能否选对动作、能否理解任务条件、输出是否适合程序使用"展开研发。Auto Research 被定义为实现 RSI 的核心元件——先让 AI 参与研究和模型改进,之后进一步要求被改进的 AI 连"改进 AI 的能力"本身也得到提升。
资源链接
- GitHub:https://github.com/StartLuxLabs/Startlux-Decision
- Hugging Face 模型合集:https://huggingface.co/collections/startlux-models/startlux-decision-6abba92b301b573fa154d493
包含五档原始模型及 15 个 GGUF 版本,项目同时提供推理、评测复现、LoRA 微调与温度校准工具。