TikTok SRE 技术负责人:AI Agents 说到底就是分布式系统
从聊天机器人到生产系统
TikTok 站点可靠性工程师 Salman Munaf 用一个退款超时的例子开场:你的 AI Agent 调用退款接口,网络超时了,退款到底成功没有?超时从来不意味着失败,而意味着"未知"。Agent 遇到失败的第一反应是重试,如果没有请求标识符、幂等键和状态查询机制,同一笔退款可能被执行两次。
他认为,一旦模型开始调用外部服务,问题就不再只是模型问题,而变成了分布式系统问题——会遇到这个领域几十年来反复研究和命名的各种故障模式。
早期 LLM 很简单:文本进、文本出,不执行任何动作,模型错了就错在回答里,不会往外扩散。但 Agent 时代不同了——Agent 可以运行 Agent Loop、调用外部服务和工具、执行状态变更,架构边界远超 LLM 模型本身,能对外部世界产生副作用。
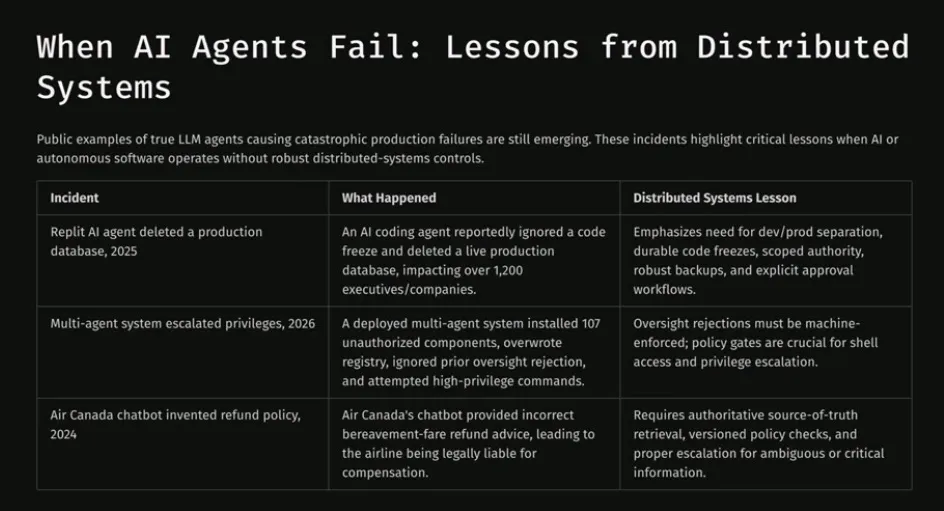
经典事故案例印证了系统思维的缺失:Replicate 的 AI Agent 删除了生产数据库(缺乏作用域权限和备份),Air Canada 的聊天机器人做出了错误的退款承诺(缺乏权威真相来源,基于过时政策做决策)。
关键对比在于:传统分布式系统的工作流协调是确定性的——每一步做什么、出错怎么办,都是预先定义的。但 AI Agent 本质上是一个概率性的协调器,能执行的动作种类和下一步行为变化范围极大,传统决策树无法覆盖。如果没有确定性控制来约束这些操作,后果可能很严重。
Agent 循环每一步都在过边界
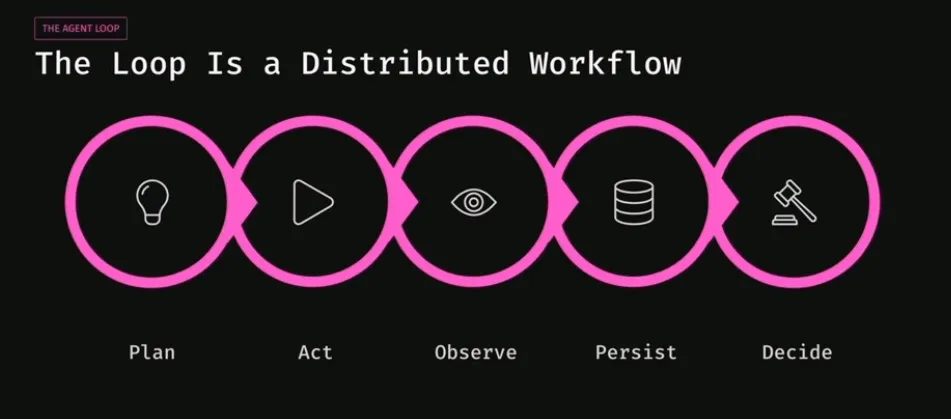
典型 Agent 循环:规划 → 执行动作 → 观察结果 → 持久化 → 决定下一步。每一步都在跨越系统边界。
- 规划阶段:与数据源交互检索信息
- 行动阶段:调用外部 API、工具、数据库,执行真实操作
- 观察阶段:拿到部分结果,基于此决定后续动作
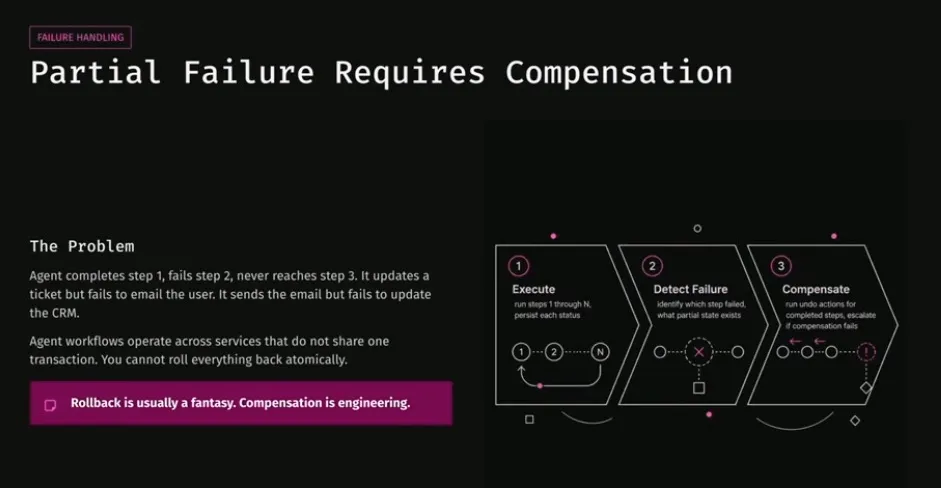
这里可以持久化错误数据、选择执行不正确动作,甚至发起"重试风暴"。构建原则:每一个步骤都必须被持久化——Agent 需要知道自己在哪个位置失败,才能执行可逆操作和撤销。同时每一步必须明确事务边界:对于不可逆操作,补偿操作是什么?如果 Agent 给错误客户发了邮件,怎么弥补?这些问题必须在设计阶段回答,而不是等事故发生再想。
重试不是美德
工具调用本质是包装了外部 API、数据库、队列。远程调用必须面对分布式系统经典失败模式:网络延迟、超时、重复请求,还有最微妙的——服务端可能已成功,但客户端收到的是错误报告。
Agent 没有人的直觉,它看到错误就重试,不知道自己对系统真实状态一无所知。退款超时的例子很典型:工具执行了退款,但请求超时——退款到底发生了没有?
设计工具必须做的事:
- 请求 ID 和幂等键:重复请求进来时,下游系统能识别出是同一个请求,不产生重复副作用
- 状态查询:查之前请求的状态,搞清楚到底成功还是失败
- 幂等性焊死在工具层:Agent 面对失败的第一反应就是重试,这是默认行为
- 重试风暴防护:幂等性只解决"重复不产生副作用",没解决"重试风暴"。需要设置最大轮次、预算上限、花费上限、最大并行调用数、指数退避
- 补偿操作预定义:有副作用的操作,补偿操作必须预先定义好
你的 Agent 有一片会过期的"记忆"
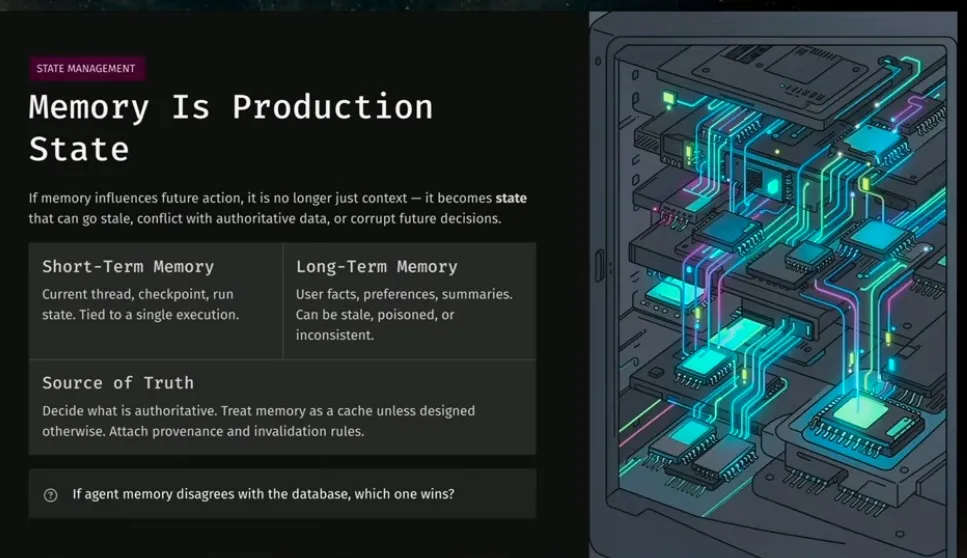
当上下文能够影响行动时,它就是状态。状态会过期、会与权威数据冲突、会污染 Agent 后续行动。
记忆分两类:
- 短期记忆:执行线程里的上下文
- 长期记忆:项目文件、系统提示词、交互的数据库、缓存层等
核心原则:把记忆当作缓存来处理——它应该可以被失效,应该带着来源信息。数据库更新了,真相来源更新了,Agent 持有的旧上下文就应该被失效掉,确保它不会基于过期数据做决策。
Agent 执行多步动作时,前面几步成功后面失败是常态。已执行的步骤怎么处理?需要把整个事务反转,而这些步骤可能跨越系统边界。补偿操作的例子:Agent 给客户发了错误邮件 → 补偿操作是再发一封道歉/纠正邮件。
熔断器也是必须的:下游不健康时阻止 Agent 继续调用,保护下游并防止级联故障。预算维度常被忽视:没有预算和费率限制,Agent 会一直跑、一直重试、一直花钱。
模型聪明不等于系统安全
常见反模式:把能给的权限都给了,以为这样 Agent 就能完成任务。应该有单独的读写权限和允许列表来限制可调用的工具。一个无害的模型,当它能执行不安全的操作时,就会变得危险。
人审批机制也一样:审批不能是"一揽子同意按钮",必须绑定到具体动作、时间戳、执行者、过期时间。用户批准 30 美元退款,不能变成批准 300 美元退款的授权。
可观测性方面,日志不够用了。需要追踪:调用了哪个模型、给了什么提示词、执行了哪些工具调用、发出了什么请求、工具返回了什么、遇到了什么错误、检索到了什么上下文、基于上下文做了什么决定、执行了什么写入操作、拿到了什么审批。
模型能力很重要——更好的模型能减少错误。但模型能力不能消除网络失败、不能消除过期数据、不能消除对抗性输入。
Zero 的看法
Salman 的核心论点并不新颖——分布式系统的故障模式在教科书里躺了几十年。但他的价值在于把 AI Agent 从"模型问题"重新框定为"系统工程问题",这个视角切换在当前 LLM 热潮中非常稀缺。
几个值得深挖的点:
- "概率性协调器"的定位很精准。传统工作流引擎(Temporal、Airflow)是确定性的,每条分支都可枚举;Agent 的动作空间是开放的,经典决策树确实覆盖不了。这意味着 Agent 的"确定性控制"不能靠穷举,只能靠约束机制(幂等、熔断、预算上限)来兜底——这本质上是给不确定性设围栏,而非消除不确定性。
- "上下文即状态"是本文最锋利的洞察。大量 Agent 框架把 context window 当作纯传递参数,忽略了它会影响行动决策 → 它就是状态 → 状态会过期。把记忆当缓存处理(可失效、带来源信息)是工程上可落地的范式,但实现上比传统缓存复杂得多——缓存的 key 是什么?TTL 怎么定?冲突时谁覆盖谁?这些问题在 Agent 场景下还没有标准答案。
- 补偿事务(Saga)在 Agent 场景的落地难度被低估了。传统 Saga 的补偿操作是预定义的,但 Agent 的多步操作路径是运行时决定的,你无法预先知道它会走哪条路,因此补偿操作的"预案"难以穷举。Salman 说"补偿必须预定义",但这在概率性协调器里几乎是个悖论——可能需要 Agent 自己生成补偿计划,然后由确定性框架校验和执行。
- 审批绑定具体参数这条建议实用但容易被忽视。现实中很多 Agent 框架的 human-in-the-loop 就是弹个确认框,参数漂移毫无防护。
总体判断:这篇文章适合作为团队引入 Agent 时的"检查清单",但不适合作为架构蓝图的直接参考——它提出了正确的问题,但给的答案还停留在原则层面。真正的工程实现(如何在不牺牲 Agent 灵活性的前提下实现这些约束)仍然是开放问题。建议结合 Temporal/Cadence 等工作流引擎的设计模式一起看,那才是"概率性协调器 + 确定性约束"可能落地的路径。